
Welcher Service gehört wem? Eine Stelle beantwortet das.
Der Service-Katalog erfasst in einem einzigen Datensatz, was jeder Service ist, wem er gehört, wovon er abhängt und wohin er deployt wird - automatisch aus Ihrer Codebasis ermittelt.

Bildschirme aus einer laufenden Installation
Das Inventar entsteht in drei Schritten
Sie füllen keine leere Tabelle von Hand. AppArch leitet Service-Kandidaten aus Ihren verbundenen Repositories ab, Sie bestätigen sie.
- 01
Erkennen
Verbundene Repositories werden gescannt, Service-Kandidaten tauchen auf. Sie prüfen die Liste und importieren oder verwerfen.
- 02
Zuordnen
Sie geben jedem Service einen Verantwortlichen, eine Kritikalitätsstufe und einen Lebenszyklusstatus. Kein Service bleibt herrenlos.
- 03
Verknüpfen
Abhängigkeiten, Deployments, die API-Spezifikation und Dokumentationslinks kommen hinzu. Der Datensatz ist vollständig.
Was steht in einem Service-Datensatz?
Freitext ist kein Feld. Jeder Datensatz hat dieselben Felder, damit das Inventar durchsuchbar und vergleichbar bleibt.
Service-Art
Service, API, Frontend, Bibliothek, Worker, Infrastruktur oder Sonstiges. Der schnellste Weg, das Inventar zu filtern.
Lebenszyklus
Experimentell, Produktion, veraltet oder stillgelegt. Es sagt Ihnen, welchen Services Sie vertrauen können.
Kritikalitätsstufe
Tier 1 ist geschäftskritisch, ein Ausfall ist ein schwerer Vorfall. Tier 3 steht für interne Werkzeuge und Experimente.
Verantwortlich
Jeder Service hat einen Entwickler oder Nutzer als Verantwortlichen. Die Antwort auf wer kennt das hier steht im Datensatz.
Abhängigkeiten
Die Infrastruktur, die ein Service mitbringt - PostgreSQL, Redis, Kafka -, wird aus den Kubernetes-Ressourcen Ihrer Deployment-Quelle abgeleitet; die verräterische Ressource wird als Beleg angezeigt.
Deployments
Sobald Argo CD, Flux oder Kubernetes verbunden ist, wird im Katalog sichtbar, welche Version wo läuft.
API-Spezifikation
Die OpenAPI-Spezifikation wird aus dem Repository, per URL oder manuell angehängt. Titel, Version und Endpunktanzahl landen im Datensatz.
Links
Dokumentation, Runbook, Dashboard, Bereitschaftsplan, Repository und API-Links stehen direkt beim Service.
Gold, Silver, Bronze: was einem Service fehlt
Jeder Service wird gegen dieselbe Liste geprüft. Eine Prüfung, die nicht passt, etwa eine API-Spezifikation für eine Bibliothek, wird weggelassen statt gegen ihn gezählt.
- Gold100%
- Silver≥ 75%
- Bronze≥ 50%
- Keine Stufe< 50%
- In den letzten 30 Tagen gescanntwenn ein Projekt verknüpft ist
- API-SpezifikationServices und APIs
- Deploytaußer Bibliotheken
- On-Call-Linknur Tier 1
Woher ein Serviceeintrag seine Daten bekommt
Verantwortliche und Links tragen Sie ein. Alles andere wird nach Zeitplan gelesen und bleibt von selbst aktuell.
- Argo CD · Flux · Kubernetes
Deployments
Alle 10 Minuten: Version je Umgebung, Sync-Status, Health sowie mitgebrachte Datenbanken, Caches und Queues.
- openapi · swagger
API-Spezifikation
Im Repository per Name gefunden (Root, docs, api, spec), von einer URL geholt oder eingefügt. Stündlich aktualisiert; ein Fehlschlag behält die letzte gute Kopie.
- ArchScan
Verknüpftes Projekt
Datum und Score des letzten Scans des Projekts hinter dem Service.
- Von Ihnen eingetragen
Verantwortliche, Tier, Lebenszyklus, Doku-, Runbook-, Dashboard- und On-Call-Links.
Wann schaut man wirklich in den Katalog?
Ein Inventar ist kein Selbstzweck. In drei Momenten zahlt es sich aus.
Ein Entwickler kommt ins Team
Wie viele Services es gibt, was jeder tut, wen man fragt. Eine Liste statt einer Woche Flurerklärungen.
Bereitschaft während eines Vorfalls
Verantwortlicher, Runbook-Link, Kritikalitätsstufe und Abhängigkeiten auf einem Bildschirm. Die Minuten, die sonst die Suche kostet, gewinnen Sie zurück.
Ein Architektur-Review
Wie viele experimentelle Services in die Produktion gerutscht sind, welcher Tier-1-Service keinen Verantwortlichen hat, welcher nie eine Gold-Scorecard erreicht hat. Die Fragen stützen sich auf Daten.
Häufige Fragen
Muss ich den Katalog von Hand füllen?
Woher stammen die Deployment-Informationen?
Was zeigen die Abhängigkeiten im Katalog?
In welchen Paketen ist der Katalog enthalten?
Wo werden unsere Daten gespeichert?
So sieht es im Produkt aus
Alle Screenshots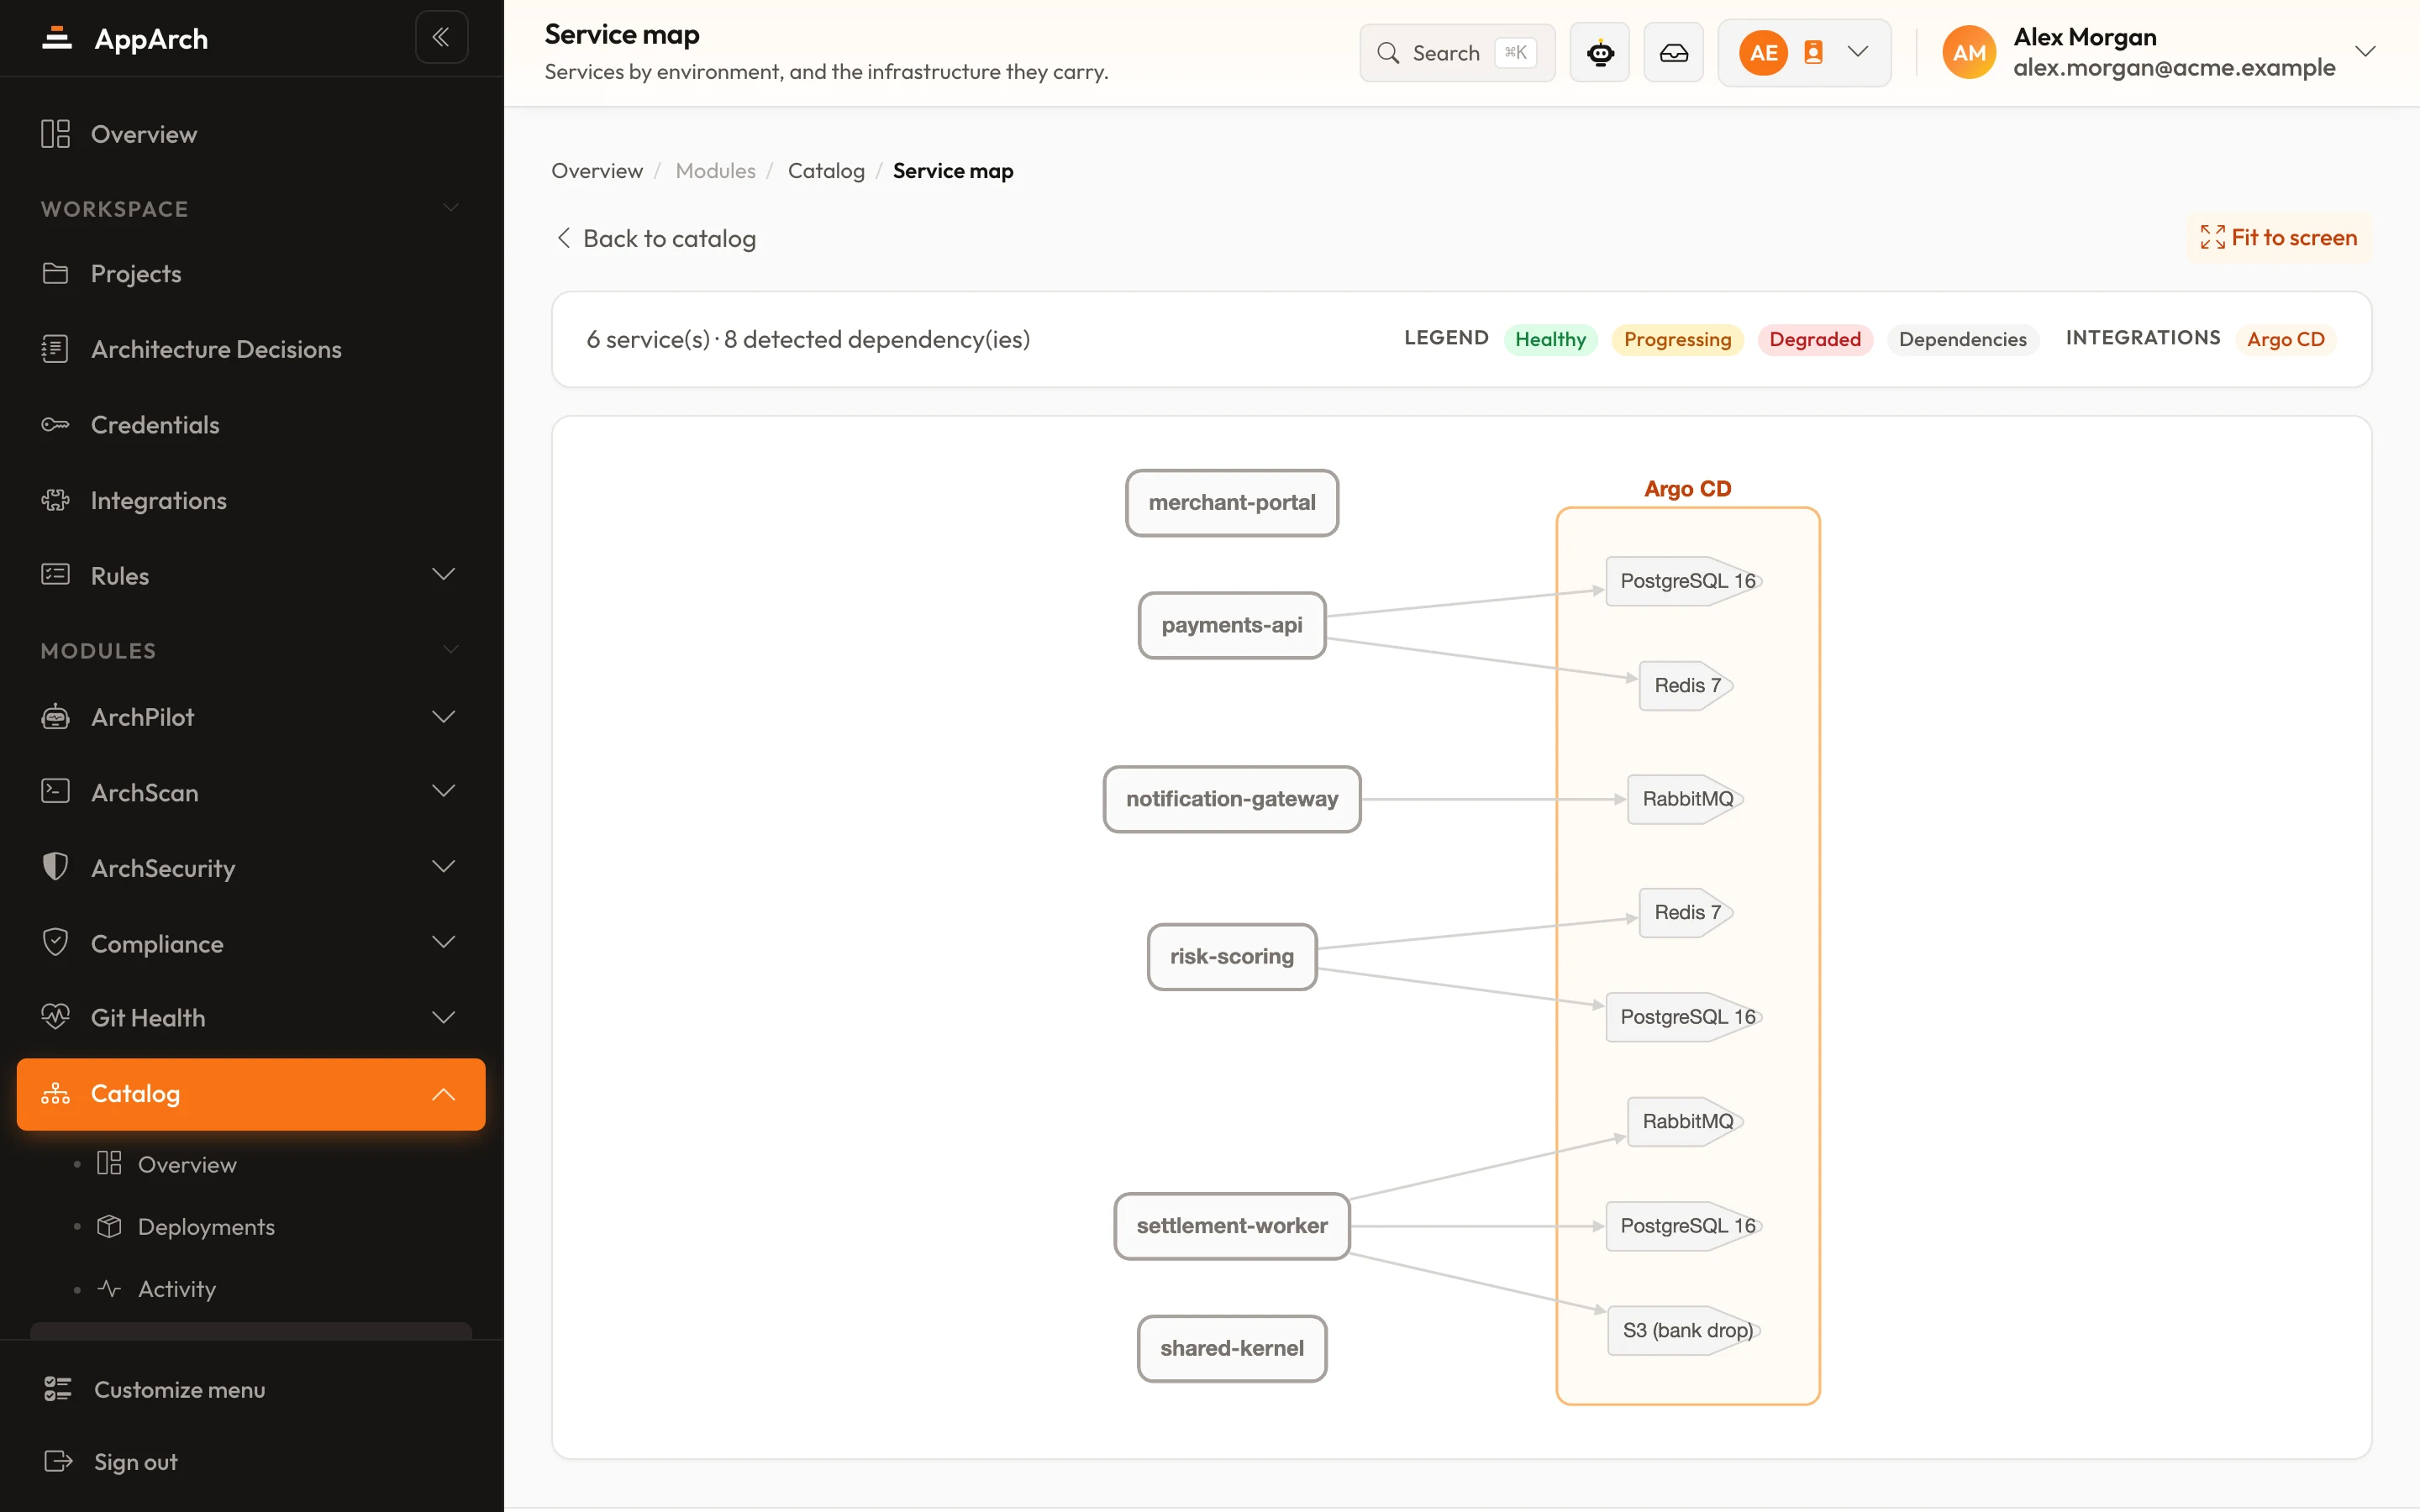
Bauen Sie Ihr Inventar an einem Nachmittag
Verbinden Sie Ihre Repositories, bestätigen Sie die erkannten Services, weisen Sie Verantwortliche zu. Der Rest bleibt von selbst aktuell.